01本篇适用条件
适用于已获批研究的分配准备与教学演练。随机分配用于降低分组偏倚,不能替代样本量论证,也不能保证每个变量完全平衡。12 个编号、两组、每区组 4 个和种子 20261101 都是教学设定,不是动物数建议;表中的动物不存在,没有提供真实体重或结果。若处理以笼为单位,须把代码中的 M 编号换成笼编号并按实际层级设计。
02实验原理
随机分配让每个实验单位按预先规则进入处理组,减少系统性偏倚。实验单位可能是单只动物、整笼或其他层级,取决于实际施加处理的层级;不能把笼内多只动物当然视为完全独立。
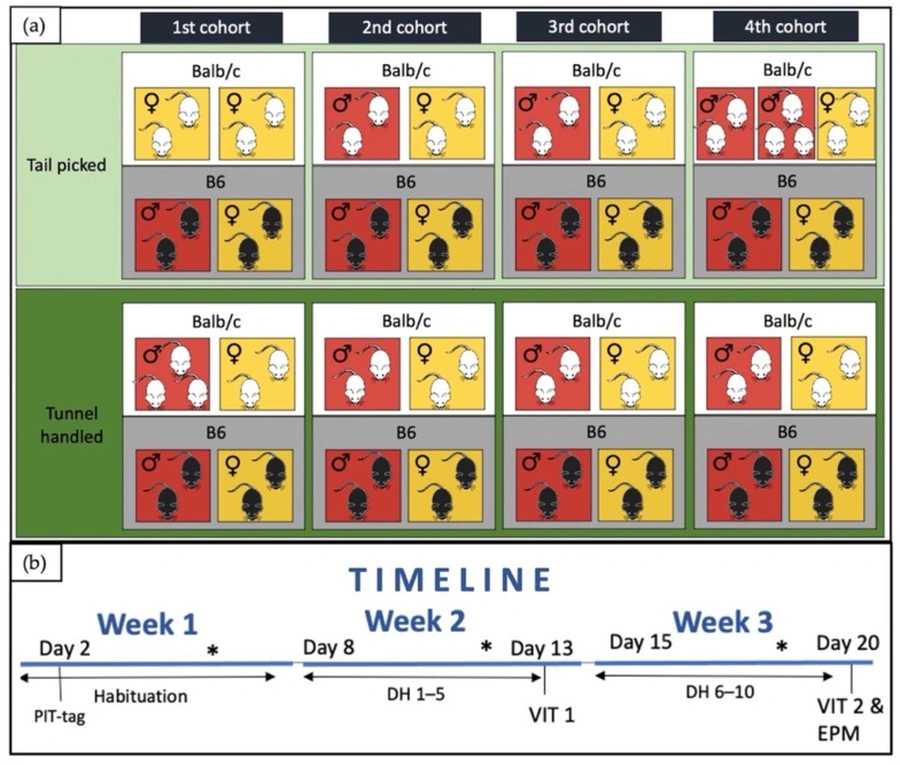
颜色和分区展示原文如何交代品系、性别、处理方式与测量时点。它是已发表研究的设计示例,不是本篇随机分配表;也不表示每种因素都可混为独立重复。原图包含旧式抓尾比较,本站操作仍按正文温和转移。
03安全与适用范围
仅供经过培训、纳入有效伦理批准的人员学习和制定记录表。动物种属、品系、性别、年龄、健康状态及实验目的会改变方案;实际操作须依照动物设施与兽医批准的 SOP。遇到痛苦或异常应停止操作并联系兽医,本页不能替代上岗培训。
04材料与仪器
- 伦理方案、纳入/排除规则、目标组量与实验单位说明。
- 稳定的唯一编号、已核对的性别/批次/基线等必要变量。
- 有权限控制的电脑、Python 3、CSV 文本编辑器和只读归档位置。
- 可独立核对分配的人员;实际组别与中性标签分开保管。
05配液与用量
本篇不配液;准备可审计的分配文件。
| 物品/文件 | 示例配置 | 用途 |
|---|---|---|
| 资格名单 v1 | CSV/只读副本各 1 份 | 冻结纳入的实验单位及顺序 |
| Python 3 环境 | 记录完整版本 | 运行固定随机算法 |
| 分配脚本和原始输出 | 各保存 1 份 | 复核种子、顺序与分配规则 |
| 独立密钥与编码标签 | 受限目录 | 让测量者看不到实际组别 |
| 核对表 | 操作者与复核者各签认 | 确认单位数、身份和标签 |
06时间安排
| 时间示例 | 任务 | 交付物 |
|---|---|---|
| 分配前 1 天,20 分钟 | 核对资格、设计层级和区组规则 | 冻结名单 v1 |
| 分配当日,10 分钟 | 运行脚本,保存版本和输出 | 不可覆盖的分配原表 |
| 随后,15 分钟 | 独立核对并制作盲化工作单 | 编码标签/映射密钥 |
| 首项测量前,10 分钟 | 核对个体身份、笼位和操作顺序 | 现场确认记录 |
| 任何损失发生时 | 登记原因,不覆盖原表 | 变更与偏离日志 |
07开始前的准备
在看到结局前决定是否分层及每层组量。教学例假设 12 个同一层的独立实验单位,按预定顺序分成 3 个区组,每区组向 A、B 各分 2 个。正式研究可按性别、批次或基线等预设因素构建区组,但不要层层细分到无法分配。若按体重排序成相邻区组,记录排序键与并列值处理规则;不要在输出后才改变区组。确认笼内关联、同笼污染或互相影响是否要求整笼分配。
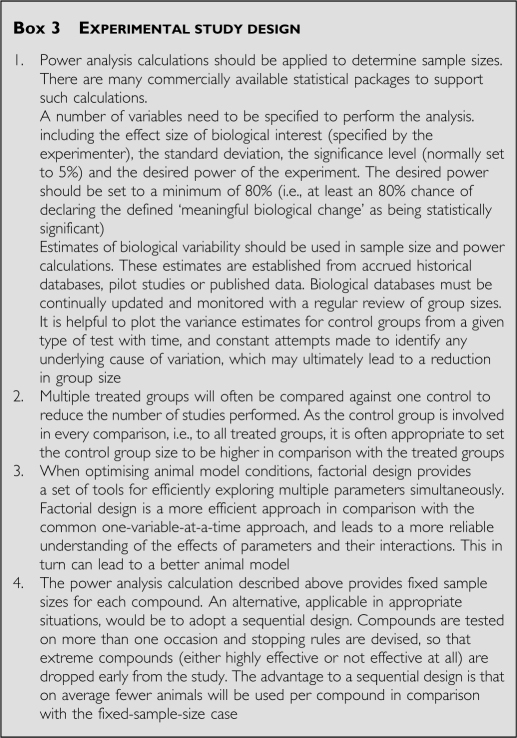
实验研究设计的原文Box 3。原出版物将文字框作为图片提供,完整保留供规划和分析核对;来源中的研究安排不能自动视为本站推荐。 所有原图panel、坐标与图例均保留。
08逐步操作
- 为每个实验单位核对唯一编号、资格和对应笼号;资格核对在分配前完成,不根据将分到哪个组调整纳入。
- 将完整输入清单按预定顺序冻结为 candidates_v1.csv,写日期、纳排理由、单位定义与负责人。保留被排除条目的审计表,不把它们悄悄删掉。
- 写下分配规则:本例 M01–M04、M05–M08、M09–M12 为三个区组,每区组 A/B 各 2 个。真实区组依据需在方案中说明;序号本身不是生物学依据。
- 指定分配者与结果测量者。分配者可见实际分配,测量者只收到中性编码工作表;同时限制访问脚本输出与密钥。
- 在终端记录 Python 完整版本,运行下面代码;保留脚本原文件、输入、输出、种子和时间。需要与教学表逐项复现时保持相同输入顺序、代码和 Python 实现/版本,并以归档输出为凭。
- 教学代码:
import random
rng = random.Random(20261101)
blocks = [
    ["M01", "M02", "M03", "M04"],
    ["M05", "M06", "M07", "M08"],
    ["M09", "M10", "M11", "M12"],
]
for block_no, block in enumerate(blocks, 1):
    ordered = block.copy()
    rng.shuffle(ordered)
    for unit, group in zip(ordered, ["A", "A", "B", "B"]):
print(block_no, unit, group, sep=",")- 将输出与下方教学表核对:每个编号恰好出现一次、每区组 4 个、A/B 各 2 个、总计各 6 个。复核者核对后签名;正式项目使用本项目输入生成自己的表。
- 若需要隐藏真实处理名称,由密钥保管人将 A/B 再映射为无含义工作编码。不要用“高剂量”“对照”或颜色暗示处理;保留福利识别所需的动物身份。
- 分开制定测量顺序的随机化或平衡表,并记录其工具、种子与日期;动物组别随机不自动解决“总是先测 A 组”的时间偏倚。
- 现场逐只核对动物编号与笼号,确认标签和表格一致后开始获批操作。笼位若需平衡,遵守设施饲养要求,不为统计方便任意混笼。
- 查看预设基线汇总与执行可行性,记录差异;不要反复换种子直到组间比较不显著。若预设有重随机规则,记录每次尝试与客观接受准则。
- 分配后有失访、误操作或排除时,新增日志写编号、发生时间、原因和盲法状态;按预定分析规则处理,不能自行把另一只换入来补齐漂亮的组量。
09结果判断与质控
教学脚本已在 Python 3.11.2 实际运行,输出汇总如下,仅用于核对算法;不代表真实动物实验数据。
| 区组 | A 组编号 | B 组编号 |
|---|---|---|
| 1 | M03、M02 | M04、M01 |
| 2 | M06、M08 | M07、M05 |
| 3 | M10、M12 | M11、M09 |
合格分配包应让复核者找到输入、规则、脚本、种子、版本、原始输出和后续偏离。随机化的目的在于降低系统偏倚,基线偶然差异仍可能出现。
10实验记录模板
| 输入版本 | 单位 ID | 区组/分层依据 | 分配组别:受限 | 工作编码 | 笼号 | 分配日期 | 复核 |
|---|---|---|---|---|---|---|---|
| 〔填写〕 | 〔填写〕 | 〔预设规则〕 | 〔填写〕 | 〔填写〕 | 〔填写〕 | 〔填写〕 | 〔签名〕 |
| 运行编号 | 脚本/输入文件 | 工具与版本 | 种子 | 输出文件 | 分配者 | 偏离说明 |
|---|---|---|---|---|---|---|
| 〔填写〕 | 〔填写〕 | 〔填写〕 | 〔填写〕 | 〔填写〕 | 〔填写〕 | 〔无/具体原因〕 |
11常见问题与排错
人数不能被区组大小整除
在分配前规定不完整区组、余数分配及实际组量,并与统计人员核对;不能看完结局再决定少一个归哪组。
电脑上每次表格都变
电子表格 RAND 一类函数可能重算。保留原始输出并导出静态值;本例脚本重新初始化种子,且输入与代码必须保持一致。
同一笼全进一个组一定错误吗
不一定。处理若作用于整笼,整笼分配可能是正确设计,但有效独立单位数与分析层级要按笼考虑。
12参考资料
- ARRIVE 2.0:Randomisation:说明是否随机及所用方法。
- NC3Rs:Experimental Design Assistant:实验单位、随机化和设计支持。
- Python random 文档:Random、seed 与 shuffle;教学分配由本篇代码实际计算。
做完最后一步,再核对原始记录。填写实际用量、起止时间与观察结果;遇到异常,先记录,再查看排错说明。